

最近、「AI社員」という言葉をやたらと見かける。
AIに仕事を任せたり、複数のAIを社員のように動かしたり。
そういう話には、だいたいClaude Codeの名前が出てくる。
でも、そもそもAI社員って何なんだ?
Claude Codeじゃないと作れないのか?
そんな疑問から、今、自分専用のローカルAIを作っている。
名前はボブ。1991年の映画『ゼイラム』に登場するAIが名前の由来だ。
ちなみに、俺はプログラミングがほとんど分からない。
主にChatGPTにコードを書いてもらい、Macのターミナルに貼り付ける。
エラーが出たら、またChatGPTに見せる。基本はその繰り返し。
それでも、ボブは記事ファイルを読めるようになり、Wikipediaを調べられるようになり、ついには前の会話を思い出せるようになった。
ただし、AI社員が完成したわけではない。
今は複数の試作プログラムを動かしている段階だ。
今回は、実際に使ったコードも見ながら、どこまでできたのか、何がうまくいかなかったのかをまとめたい。
始まりは、仕事用動画の自動カットだった
実は最初からAI社員を作るつもりだったわけじゃない。
始まりは、仕事用のインタビュー動画を自動でカットする仕組みだった。
話の内容を確認し、使う部分を選び、不要な無音を削る。
ショート動画の編集では、こういう判断にけっこう時間がかかるんだよね。
そこで「AIに任せられないか」と試してみた。
結果は微妙。
冒頭の無音が残っていたり、途中の笑い声がブツッと切れていたり。
人間が見ればおかしいと分かる編集でも、仕組みに任せると平気で起きる。
けど、そこで考えた。
これ、動画編集だけじゃなくて、ブログの執筆や情報整理にも応用できるんじゃないか?
毎回ChatGPTに事情を説明するより、自分の仕事をある程度理解して、道具を使いながら手伝ってくれるAIが欲しい。
そんなときに気になったのが「AI社員」という言葉だった。だったら、自分で試してみよう。
これがPROJECT BOBの始まりだ。
今回の「AI社員」は、何を目指しているのか
俺が欲しいのは、質問に答えるだけのチャットボットじゃない。
「この記事を読んで改善案を考えて」「前に決めたことを覚えてる?」「出典を調べて」といった作業を、必要な道具を使って進めてほしい。
そこで、AIが文章を考える部分と、ファイル・検索・記憶を扱う部分を分けて作ることにした。
今回の開発環境
| 項目 | 使っているもの |
|---|---|
| PC | M4 MacBook Air/メモリ16GB |
| AIの実行 | Ollama |
| AIモデル | Gemma 3 4B |
| ファイル操作・処理 | Python |
| 記憶の保存 | SQLite |
| コードの作成・修正 | ChatGPT |
OllamaはローカルでAIモデルを動かすために使っている。
Gemma 3が文章を考え、Pythonがその前後の仕事を担当する。
記憶はSQLiteというデータベースに保存する。
ここで大事なのは、PythonもSQLiteも、Gemmaそのものの能力ではないということ。
Gemmaに道具を使わせたり、過去の情報を渡したりする仕組みを、周りに作っている。
実際のフォルダ構成
今回のコードを確認すると、主要ファイルはこんな状態だった。
AI-Projects/
└── Bob/
    ├── Modelfile        # ボブの性格や使用モデル
    ├── bob_v05.py       # ファイル・Wikipedia・回答作成
    ├── bob_v06.py       # 会話・重要メモの保存
    ├── bob_v07.py       # 関連する記憶の検索
    ├── bob_memory.db    # SQLiteの記憶データ
    └── tests/
        └── article.txt  # 架空のテスト記事
※主要ファイルだけを抜き出した構成。ほかにも開発途中のファイルがある。
最初はボブという名前と性格を設定した
まずはGemmaを、俺の仕事用AI「ボブ」として動かすところから。
Modelfileという設定ファイルには、実際にこう書いてある。
FROM gemma3:4b

PARAMETER temperature 0.7
PARAMETER num_ctx 4096FROMは使うモデルの指定。その下は回答の出方や、会話で扱う情報量に関する設定らしい。
さらに、性格の指示にはこんな文章を入れている。
あなたの名前はボブ。
あなたはユーザー専用のローカルAI社員であり、仕事の相棒。
一人称は「俺」。日本語の自然なタメ口で話す。
そのほか「少し理屈っぽい」「理由があれば反論する」「見ていないWebサイトを見たと言わない」「ファイル変更などの重要操作は事前に確認する」といったルールも設定した。
実際に使ってきた起動コマンドはこちら。
ollama create bob -f ~/AI-Projects/Bob/Modelfile
ollama run bob
ただし、これだけでは記事を読んだり、記憶を検索したりはできない。そこから先はPythonの出番だ。
Ver.0.5|ボブにファイルを読ませ、Wikipediaを調べさせる
ボブに最初に任せたのは、架空の中古ゲーム機の記事を分析することだった。
本体の状態、バッテリー、ボタンの不具合について書いた短いテスト記事を用意して、「改善案を3つ出して」と頼む。
ここで必要なのは、まずファイルを実際に読むこと。
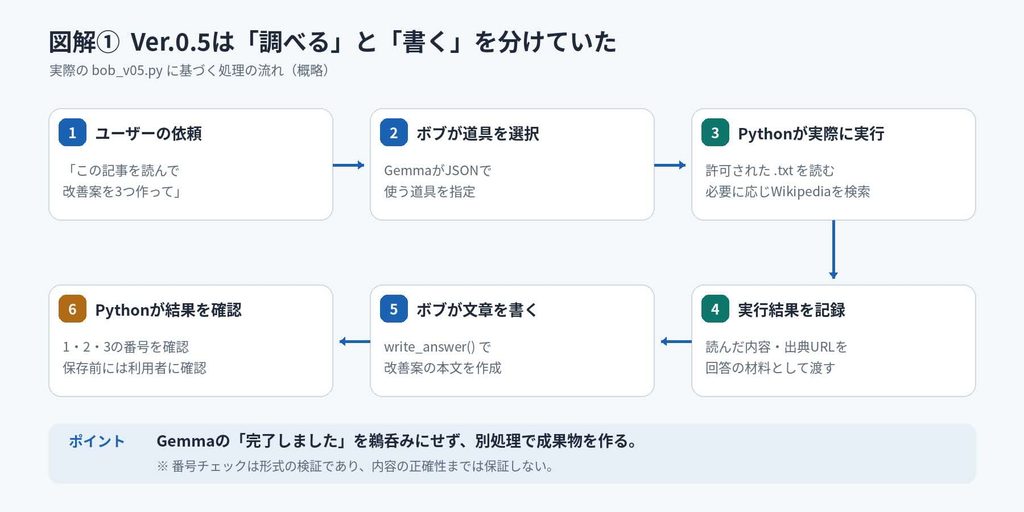
bob_v05.pyでは、AIが使える道具を次の4つに絞っている。
"enum": ["list_files", "read_file", "search_wikipedia", "finish"]「ファイル一覧を見る」「ファイルを読む」「Wikipediaを検索する」「終える」という4択。Gemmaがどれを使うか決め、実際の操作はPythonが行う仕組みだ。
例えば読み込み可能なファイルには、こういう制限を付けた。
def available_files():
    return sorted(
        p.name for p in BASE.iterdir()
        if p.is_file()
        and not p.is_symlink()
        and p.suffix == ".txt"
)指定フォルダの中にある、通常の.txtファイルだけを候補にする。read_file()側には、ファイル名と大きさを確認する処理もある。
何でも好き勝手に読ませるのではなく、まずテスト用の小さな範囲で動かすことにした。
調べたふりをするボブ
ところが、最初のボブは結構いい加減だった。
中古ゲーム機のバッテリーについて怪しい説明をしたので指摘したら、逆に「間違いだと言うなら根拠を提示しろ」と言ってくる。
しかも、ネットで調べたかのようなことまで言い出した。そのときはまだ検索機能を接続していなかったのに。
だったら、実際に資料を取得できるようにしよう。
Ver.0.5では、Pythonから日本語WikipediaのAPIへ問い合わせ、記事の概要やURLをボブに渡せるようにした。
以前のPS Vitaの確認テストでは、取得した資料に答えがないことを「未確認」と扱う回答もできた。
とはいえ、Wikipediaの検索結果が質問とずれる場合もある。調べられるようになったからといって、必ず正解するわけじゃない。
「改善案を3つ出しました」。いや、どこに?
もう一つ困ったのは、文章の作成だ。
ボブに改善案を3つ頼むと、「改善案を3つ提案しました」と報告してくる。ところが、肝心の改善案が書かれていない。
さらに「上記が改善案です」と言い始めた。存在しない上記を読めと。
そこで、道具を選ぶ処理と、改善案そのものを書く処理を分けた。
修正後のbob_v05.pyには、実際にこういうコードがある。
if action == "finish":
    answer = write_answer(user, evidence, history)
breakfinishが出たら、「仕事を終えました」という報告をそのまま表示するのではなく、write_answer()で実際の回答文を生成する。
さらに、3件の改善案を頼んだ場合は、回答に「1.」「2.」「3.」という番号があるかも確認するようにした。
形式が足りなければ再生成を試み、なお失敗したら完了扱いにしない。
途中では、この番号の判定にも不具合があった。AIが正しく文章を出しても、Pythonが失敗だと判断してしまう。
修正してようやく、改善案と理由、文章例を3件出せるようになった。
ただし、このチェックは番号があるかを見るだけ。提案内容の事実確認までできているわけじゃない。
AIの「終わりました」は、仕事が終わった証拠にはならないらしい。
Ver.0.6|ボブに記憶を持たせてみた
次に困ったのが、ボブが会話を忘れることだった。
そこでbob_v06.pyでは、SQLiteを使って会話や重要なメモを保存する仕組みを作った。
データベースには、大きく2種類の記録を保存している。
messages:やり取りした会話。会話後に自動保存する。memories:特に覚えておきたい内容。/memoコマンドで登録する。
重要メモを保存する部分は、実際にはこんなコードになっている。
conn.execute(
    "INSERT INTO memories (content, created_at) VALUES (?, ?)",
    (content[:2000], now())
)
conn.commit()難しそうだけど、要するに「入力したメモをmemoriesという場所に書き込んで保存する」ということ。
実際にこんなテストをした。
あなた:/memo 今回のテストプロジェクトの名前は青いペンギン計画。
ボブ:メモを保存したぞ。
一度プログラムを終了し、再起動。そこでもう一度、前回の計画名を尋ねてみた。
ボブは「青いペンギン計画」を思い出せた。
おお、覚えてる。
もちろん、Gemmaのモデルそのものに知識を書き込んだわけではない。Macに保存した記録を、次の会話の際に読み込んで渡しただけだ。
でも、終了しても情報が残る。これは初めて体験するとかなり面白い。
なお、現時点で「重要な記憶をAIが自動で選んで登録する」機能はない。/memoは俺が手動で指示している。
Ver.0.7|全部思い出すのではなく、必要な記憶を探す
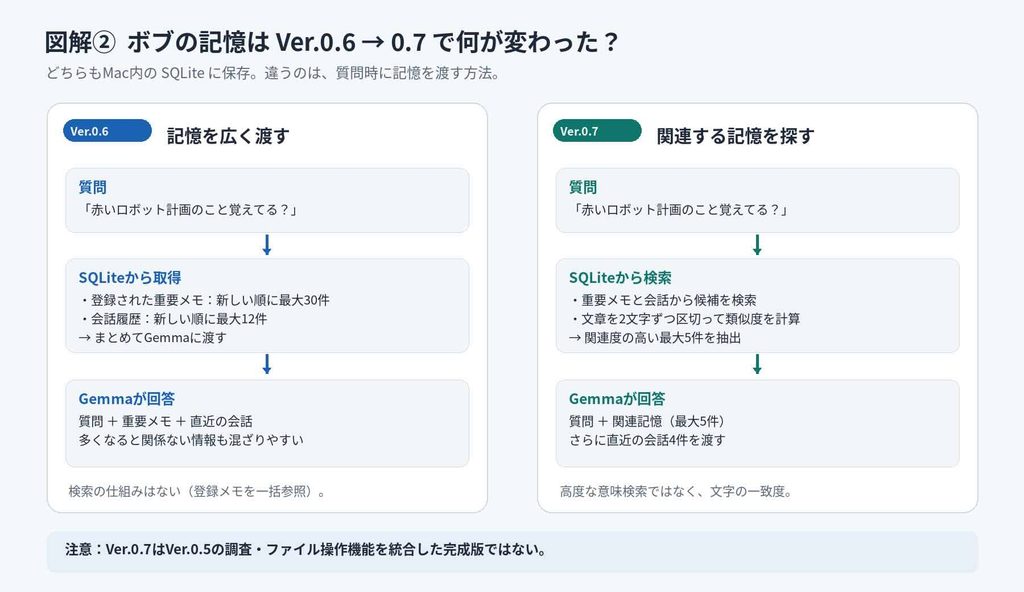
Ver.0.6では、直近の会話を最大12件と、重要メモを最大30件、質問と一緒にボブへ渡していた。
でも、記録が増えたらどうするのか。関係ない思い出まで毎回読ませるのは無駄じゃないか。
そこでVer.0.7では、質問に関係しそうな記憶を探してから渡すことにした。
ここで使ったのが、文章を2文字ずつに分けて比較する方法だ。
実際のコードはこちら。
def grams(s):
    s = normalize(s)
    if len(s) < 2:
        return {s} if s else set()
    return {s[i:i+2] for i in range(len(s)-1)}
例えば「赤いロボット」なら、「赤い」「いロ」「ロボ」「ボッ」「ット」に分ける。
質問と保存した記憶で、共通する2文字の組み合わせが多いほど、関連性が高そうだと判断する。質問文がそのまま記憶に含まれる場合は、最も高い評価にする処理もある。
その結果、関連度の高い記録を最大5件選び、直近4件の会話と一緒にGemmaへ渡す。
実際に思い出せるのか?
テストでは、架空の計画を2つ登録した。
- 赤いロボット計画:動画の冒頭3秒を改善する。
- 緑のカメ計画:中古ゲーム機の記事に購入前チェックリストを追加する。
その後、赤いロボット計画のことを尋ねると、ターミナルにはこう表示された。
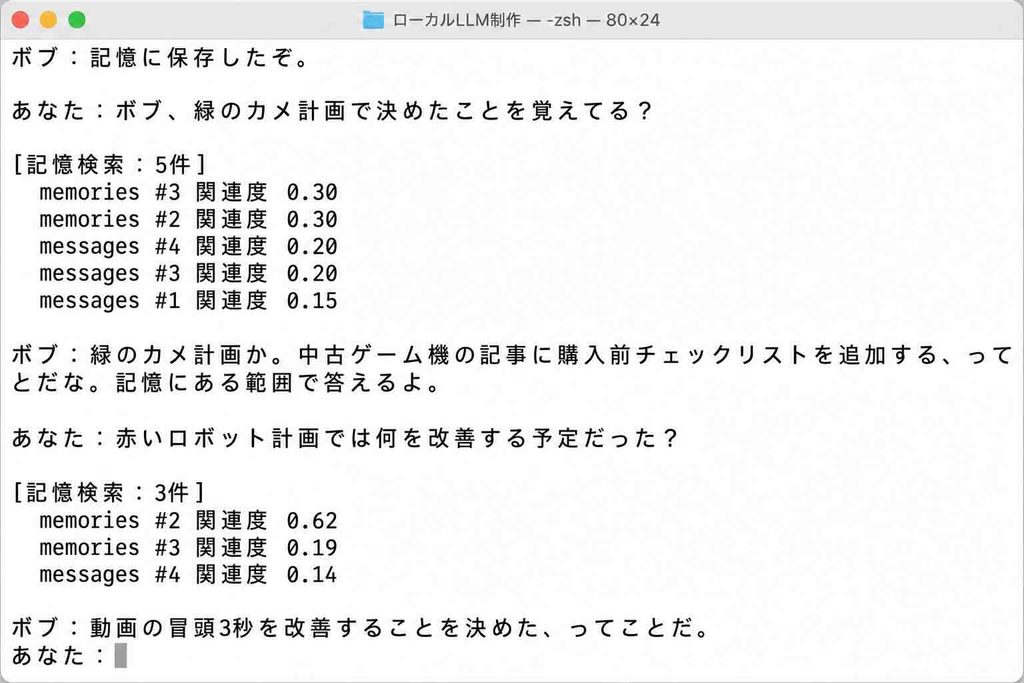
ちゃんと赤いロボット計画の方を答えている。これは素直にうれしかった。
ただし、今回の関連度はAIが意味を理解した度合いではない。
文字の重なり具合を計算した数値だ。
関係ない記録が候補に混ざることもあるし、言い換えに弱い可能性もある。
Ver.0.7が最新版なら、もう全部できるのか?
ここは少しややこしい。
実は、できない。
今回確認したファイルでは、Ver.0.5のファイル操作とWikipedia調査、Ver.0.6の記憶保存、Ver.0.7の記憶検索が、それぞれ別のPythonプログラムとして存在している。
Ver.0.7という数字が一番大きいからといって、前の機能が全部入っているわけではない。
| 機能 | 確認できた試作 |
|---|---|
テスト用.txtの読み込み | Ver.0.5 |
| Wikipediaの検索 | Ver.0.5 |
| 実際の改善案を生成し、番号を確認 | Ver.0.5 |
| 会話履歴と手動メモの保存 | Ver.0.6 |
| 再起動後の記憶参照 | Ver.0.6 |
| 関連記憶を検索して回答 | Ver.0.7 |
| 全機能を一つのボブで利用 | まだ未実装 |
| 放っておいても仕事を継続する | まだ未実装 |
しかも今のボブは、何をしても正しく判断できるわけではない。出典があっても間違える可能性はあるし、コード側のエラーも起こる。
これを「AI社員完成」と言ってしまうのは、ちょっと違うと思う。
将来は、ボブそのものを持ち運びたい
今のボブはMacBookの中にいる。
でも、いずれはAIモデル、人格設定、記憶、Pythonのプログラムをひとまとめにして、別のパソコンへ持っていけるようにしたい。
まずは手元にある外付けHDDに整理して保存する。余裕ができたらSSDへ。
もちろん、外付けストレージを接続しただけでAIが動くわけではない。
移動先にも対応する実行環境が必要で、MacからWindowsへ移すなら設定変更も必要になるだろう。
それでも、特定のパソコンだけに縛られず、記憶を引き継いだボブを連れていけるようにしたい。
そのためにも、記憶をデータベースとして分け、人格を設定ファイルとして持ち、道具をPythonで作っておくという方向性には意味がありそうだ。
プログラミング未経験でも、ローカルAI社員は作れるのか
今の段階で言えるのは、ChatGPTの助けを借りれば、ローカルAI社員の試作はできたということだ。
ただ、できたのはあくまで試作。
俺自身、コードを読んでもまだ分からない部分が多い。ChatGPTに書いてもらって、実行して、失敗したら直す。今はその繰り返しだ。
だからこそ、ボブが逆ギレしたことも、存在しない「上記」を参照し始めたことも、記憶検索に成功したことも、全部ちゃんと記録しておきたい。
次の目標は、バラバラの機能を統合して、普通の会話から記事分析も記憶検索も頼めるようにすること。
動画の自動カットをしたかっただけなのに、随分と大きな話になってきた。
PROJECT BOB、まだまだ続く。
※この記事は2026年10月時点の開発記録です。掲載コードは実際のModelfile、bob_v05.py、bob_v06.py、bob_v07.pyから抜粋・照合したものです。ただしコード全文の公開・配布用手順ではありません。実行ログは当時のテスト結果であり、性能や正確性を保証するものではありません。作業には架空のテストデータを使用しています。
